/parse — o apunta /scrape
a la URL de un documento público — y obtén markdown, contenido por página, bloques de
diseño tipados o JSON estructurado.
- Con reconocimiento del diseño: encabezados, párrafos, tablas y fórmulas organizados en orden de lectura
- Incluye documentos escaneados: extracción de texto nativo con OCR como alternativa para páginas que solo contienen imágenes
- Estructura basada en el documento: bloques de diseño tipados con cuadros delimitadores y enlaces a rangos de caracteres en el markdown (PDF)
- Cualquier formato habitual: PDF, Word, Excel, PowerPoint, OpenDocument, EPUB, CSV, HTML
- Compatible con retención de datos cero
Inicio rápido
¿Tienes una URL pública de un documento en lugar de un archivo?
/scrape
detecta el tipo de archivo y lo procesa de forma idéntica — mismas opciones, misma salida:
firecrawl.scrape("https://example.com/report.pdf").Respuesta
Los SDK devuelven el objeto de documento directamente. cURL devuelve la carga útil en JSON.numPages es el número de páginas realmente procesadas; totalPages es el
número real de páginas del documento. Coinciden a menos que maxPages haya truncado el resultado; p. ej., procesar
un PDF de 100 páginas con maxPages: 10 devuelve numPages: 10 y totalPages: 100, por lo que
totalPages > numPages indica que la salida se truncó. totalPages se omite
cuando no se puede determinar el número de páginas.Markdown físico por página (PDF)
Establecepages: true en el parser de PDF y el documento también
incluye un array pages con el markdown de cada página física, útil cuando
necesitas saber de qué página proviene el contenido o procesar las páginas de forma independiente.
Sin costo adicional.
Marcadores de página (PDF)
ConfigurapageMarkers: true en el procesador de PDF y las páginas del
propio documento markdown se separarán con un marcador de comentario HTML que indica la
página física siguiente:
<!-- page N -->, con índice inicial 1). Sin costo adicional.
Los marcadores aparecen solo entre páginas: no hay un marcador inicial para la página 1.
La numeración puede omitir una página cuando el parser fusiona contenido a través de un salto de página
(una tabla u oración que continúa en la página siguiente no deja ningún límite que
marcar). Usa
pages: true cuando necesites cada
página física por separado; las dos opciones se pueden combinar.Bloques de diseño (PDF)
Estableceblocks: true en el parser de PDF y el documento también
incluye un array blocks: para cada página, los bloques de diseño tipados que detectó
el motor de procesamiento, con geometría y procedencia. Es la contraparte estructurada
del markdown: úsala para la fundamentación de citas, superposiciones de resaltado
o auditar el contenido de un documento. Sin costo adicional.
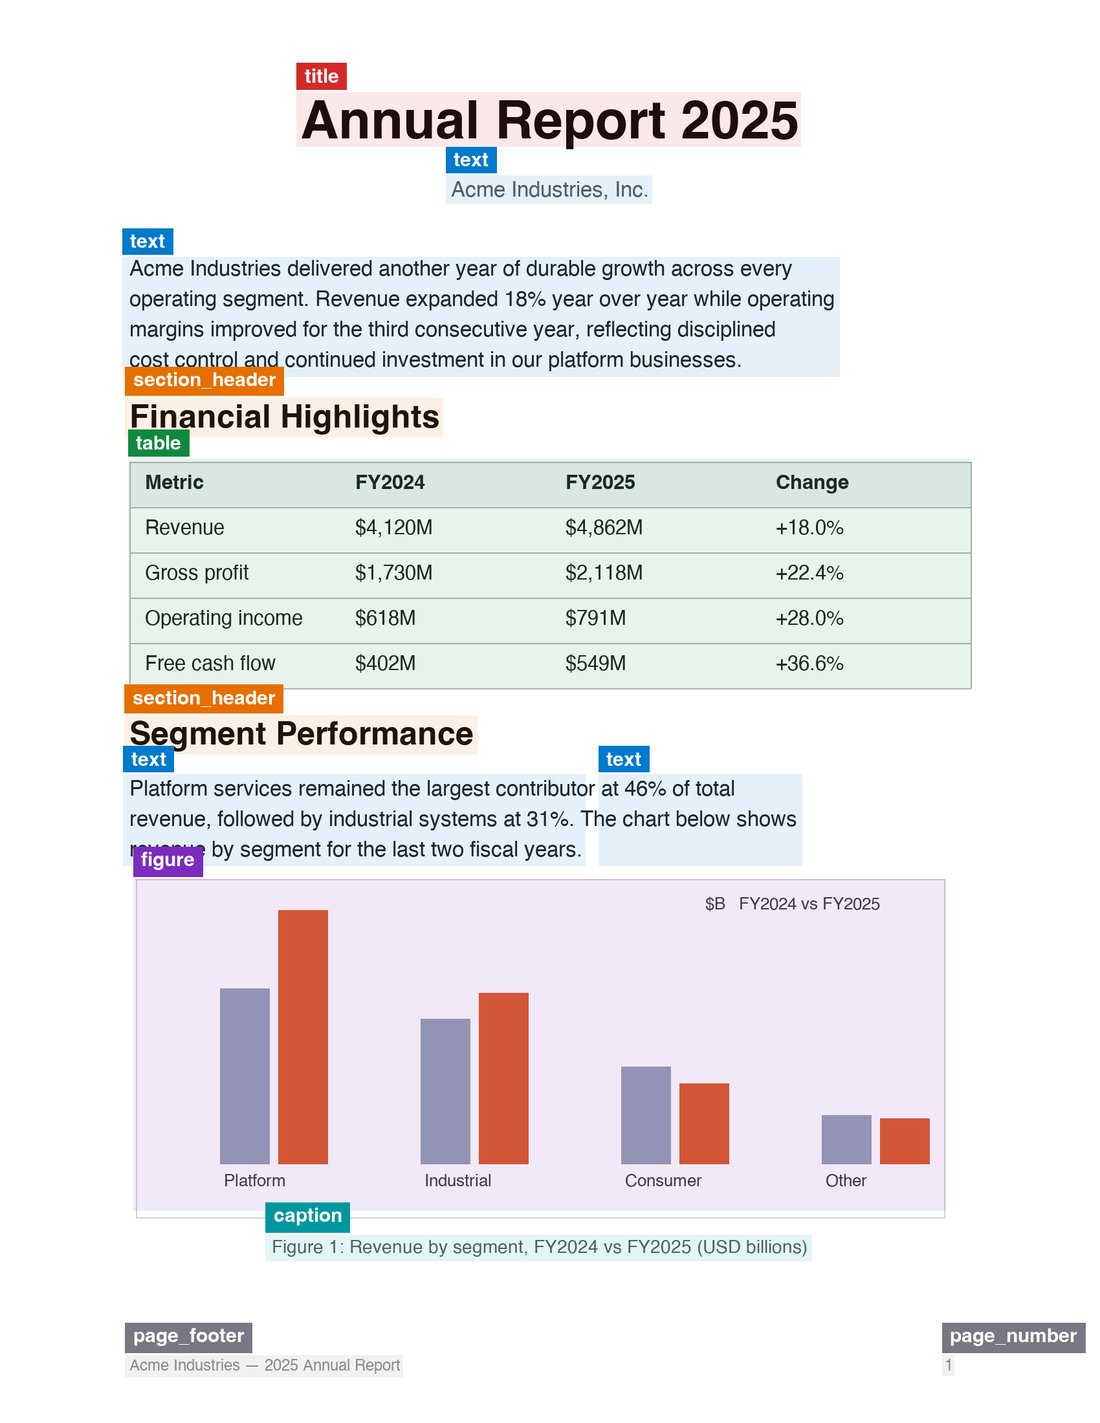
Todos los bloques que detecta el motor, tipados y posicionados: las mismas regiones que se convierten en markdown.
Campos de bloque
Fundamentación: de una respuesta a la página
markdownSpan vincula cada bloque con la subcadena exacta del markdown que
generó. Esto hace que la fundamentación de las citas sea una búsqueda, no una inferencia: busca el
texto citado en el markdown, encuentra el bloque cuyo intervalo cubre ese desplazamiento
y tendrás el número de página y el cuadro delimitador, sin pedirle nunca
coordenadas a un modelo de lenguaje.
Salida JSON estructurada
Proporciona un JSON schema o un prompt para extraer datos estructurados directamente del documento:Opciones de PDF
Todo el comportamiento relacionado con PDF se controla mediante la opciónparsers, tanto en /parse como en
/scrape:
Al pasar
parsers: [], se omite por completo el procesamiento y se devuelve el PDF en base64
(1 crédito fijo).
Modos de procesamiento
Formatos compatibles
Extensiones:.html, .htm, .xhtml, .pdf, .docx, .doc, .docm, .odt, .ods, .odp, .rtf, .xlsx, .xls, .xlsm, .xlsb, .pptx, .ppt, .pptm, .epub, .csv.
Consulta Document Parsing para saber cómo se
convierte cada formato.
Referencia de la solicitud
La solicitud esmultipart/form-data con una parte file obligatoria y una
parte JSON options opcional. options acepta un subconjunto de las opciones de scraping:
formats: array de formatos de salida. El valor predeterminado es["markdown"]. Admitidos:markdown,html,rawHtml,links,images,resumenyjson(con un schema o prompt).onlyMainContent: Solo devuelve el contenido principal del documento. El valor predeterminado estrue.includeTags/excludeTags: Inclusión o exclusión por etiqueta (entradas HTML).redactPII: Redacta la información de identificación personal del markdown devuelto.timeout: Tiempo de espera de la solicitud en milisegundos. El valor predeterminado es30000; el máximo,300000.parsers: Opciones del parser de archivos — consulta las opciones de PDF.
/parse no admite opciones exclusivas del navegador como actions, waitFor, location, mobile o seguimiento de cambios.Consideraciones
- El tamaño máximo de archivo es de 50 MB por solicitud.
- El procesamiento de PDF se factura a 1 crédito por página; las opciones
pages,blocksypageMarkersno generan ningún costo adicional. - Procesar archivos PDF muy grandes o escaneados en modo
ocrpuede tardar más; aumentatimeouto usamaxPagespara limitar el procesamiento. - Para lotes de archivos, llama a
/parsepor archivo en paralelo; no existe una variante de carga por lote.
¿Eres un agente de IA que necesita una API key de Firecrawl? Consulta firecrawl.dev/agent-onboarding/SKILL.md para ver las instrucciones de incorporación automatizada.