/parse — ou use /scrape
em uma URL pública de documento — e receba markdown, conteúdo por página, blocos
de layout tipados ou JSON estruturado.
- Preserva o layout: títulos, parágrafos, tabelas e fórmulas organizados na ordem de leitura
- Inclui documentos digitalizados: extração de texto nativo com OCR como alternativa para páginas que contêm apenas imagens
- Estrutura fundamentada: blocos de layout tipados com caixas delimitadoras e links para intervalos de caracteres no markdown (PDFs)
- Compatível com formatos comuns: PDF, Word, Excel, PowerPoint, OpenDocument, EPUB, CSV, HTML
- Suporte a Zero Data Retention
Guia de início rápido
Tem uma URL pública de documento em vez de um arquivo?
/scrape
detecta o tipo de arquivo e faz o parsing da mesma forma — com as mesmas opções e o mesmo resultado:
firecrawl.scrape("https://example.com/report.pdf").Resposta
Os SDKs retornam diretamente o objeto de documento. O cURL retorna o payload JSON.numPages é o número de páginas efetivamente analisadas; totalPages é a
contagem real de páginas do documento. Os valores coincidem, a menos que maxPages tenha truncado o resultado — por exemplo, analisar
um PDF de 100 páginas com maxPages: 10 retorna numPages: 10 e totalPages: 100, então
totalPages > numPages indica que o resultado foi truncado. totalPages é omitido
quando não é possível determinar a contagem de páginas.Markdown por página (PDF)
Definapages: true no parser de PDF, e o documento também
inclui um array pages com o markdown físico de cada página — útil quando você
precisa saber de qual página veio o conteúdo ou processar as páginas de forma independente.
Sem custo adicional.
Marcadores de página (PDF)
DefinapageMarkers: true no parser de PDF, e as páginas no
markdown do documento serão separadas por um marcador de comentário HTML que identifica a
página física seguinte:
<!-- page N -->, com numeração iniciando em 1). Sem custo adicional.
Os marcadores aparecem apenas entre as páginas — não há marcador inicial para a página 1.
A numeração pode pular uma página quando o parser mescla conteúdo em uma quebra de página
(uma tabela ou frase que continua na página seguinte não deixa um limite para
marcar). Use
pages: true quando precisar de cada
página física separadamente; as duas options podem ser combinadas.Blocos de layout (PDF)
Definablocks: true no parser de PDF, e o documento também
passará a incluir um array blocks: para cada página, os blocos de layout tipados que o mecanismo de
análise detectou, com geometria e origem. Este é o equivalente estruturado do
markdown — use-o para fundamentação de citações, criar sobreposições de destaque
ou auditar o conteúdo de um documento. Sem custo adicional.
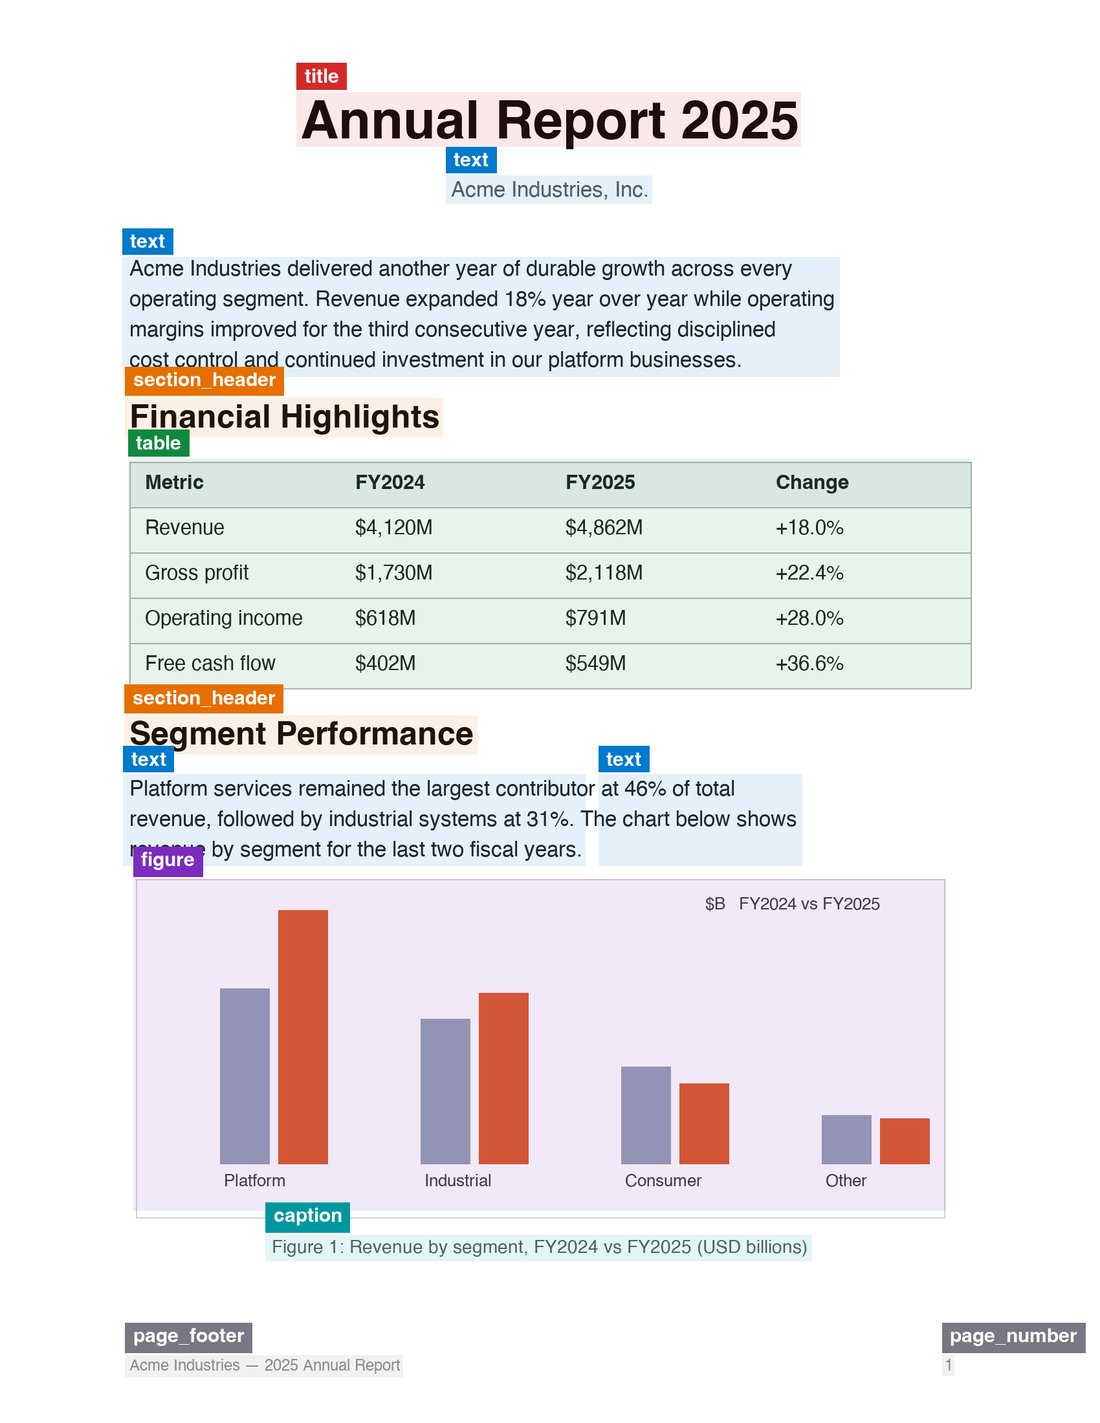
Todos os blocos que o mecanismo detecta, tipados e posicionados — as mesmas regiões que se tornam o markdown.
Campos do bloco
Fundamentação: de uma resposta à página
markdownSpan vincula cada bloco ao trecho exato do markdown que ele
produziu. Isso torna a fundamentação de citações uma consulta, não uma inferência: encontre o
texto citado no markdown, localize o bloco cujo intervalo abrange esse deslocamento
e você terá o número da página e a caixa delimitadora — sem jamais precisar pedir
coordenadas a um modelo de linguagem.
Resultado JSON estruturado
Passe um schema JSON ou um prompt para extrair dados estruturados diretamente do documento:Opções de PDF
Todo o comportamento relacionado a PDFs é controlado pela opçãoparsers, tanto em /parse quanto em
/scrape:
Passar
parsers: [] ignora completamente a análise e retorna o PDF em base64
(1 crédito fixo).
Modos de análise
Formatos compatíveis
Extensões compatíveis:.html, .htm, .xhtml, .pdf, .docx, .doc, .docm, .odt, .ods, .odp, .rtf, .xlsx, .xls, .xlsm, .xlsb, .pptx, .ppt, .pptm, .epub, .csv.
Consulte análise de documentos para saber como cada formato é
convertido.
Referência da requisição
A requisição émultipart/form-data, com uma parte file obrigatória e uma
parte JSON options opcional. options aceita um subconjunto das opções de scraping:
formats: Array de formatos de resultado. O padrão é["markdown"]. Compatíveis:markdown,html,rawHtml,links,images,summaryejson(com um schema ou prompt).onlyMainContent: Retorna apenas o conteúdo principal do documento. O padrão étrue.includeTags/excludeTags: Inclusão ou exclusão em nível de tag (entradas HTML).redactPII: Redige informações de identificação pessoal do markdown retornado.timeout: Tempo limite da requisição em milissegundos. O padrão é30000, máximo de300000.parsers: Controles do parser de arquivos — consulte as opções de PDF.
/parse não oferece suporte a opções exclusivas do navegador, como actions, waitFor, location, mobile ou rastreamento de alterações.Considerações
- O tamanho máximo do arquivo é de 50 MB por requisição.
- A análise de PDFs é cobrada a 1 crédito por página; as opções
pages,blocksepageMarkersnão geram custo adicional. - A análise de PDFs muito grandes ou digitalizados no modo
ocrpode demorar mais — aumente o valor detimeoutou usemaxPagespara limitar o processamento. - Para lotes de arquivos, chame
/parsepara cada arquivo em paralelo; não há opção de upload em lote.
É um agente de IA que precisa de uma chave de API do Firecrawl? Consulte firecrawl.dev/agent-onboarding/SKILL.md para ver instruções de onboarding automatizado.